回首頁  
帳號
 
關於博碩 博碩好讀 校園圖書 MOCC認證 下載教學 元學堂

博碩好讀
  新書推薦
  出版預告
  名家名著
  iT達人祕笈
 

分類索引


出版總覽


讀者服務

  徵求作者
 
首頁 >> 書籍介紹
 
 
點我可放大圖片
 
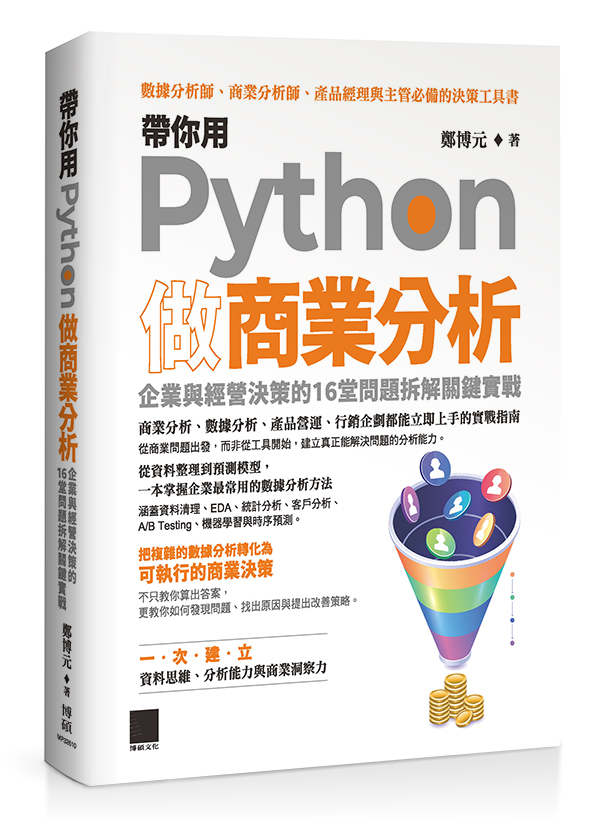
書名:帶你用 Python 做商業分析:企業與經營決策的 16 堂問題拆解關鍵實戰
書號:MP32610 作者:鄭博元 ISBN: 978-626-414-607-4
定價:NT$800元 印刷:單色 頁數:544頁
書籍規格:17*23 上市日:2026/9/19 譯者:(無)
學習定位:初階 本書附件:無  
前往購買 >> 蝦皮購物 類別:電腦技術  
       
快速前往 快速前往        


    數據分析的價值,不在於數字,而在於決策


    過去十年,「數據分析」已從少數大型企業的專業能力,逐漸成為各行各業的基本競爭力。無論是零售、電商、金融、製造、遊戲、醫療,甚至是政府部門,都在談論數據驅動決策(Data-Driven Decision Making)。然而,當我們真正走進企業現場,卻經常看到一個有趣的現象:企業擁有大量資料,也建立了許多報表,但真正能夠透過數據改善決策的人,並不多。原因在於,多數人學會了工具,卻沒有學會分析。

    許多人會使用 Excel、SQL、Python 或 BI 工具,也能產出各種精美圖表,但當主管提出:「為什麼營收下降?」「這次促銷真的有效嗎?」「哪些客戶最有價值?」「我們該把資源投入在哪裡?」時,卻不知道該如何透過數據找到答案。因為數據分析從來不是工具競賽,而是一種思考方式。真正優秀的分析師,不只是會寫程式的人,而是能夠將商業問題轉譯成分析問題,再把分析結果轉譯回商業決策的人。本書正是以這樣的理念出發。

    第一部分中,我們將建立數據分析最重要的基礎能力,包括商業思維、資料清理、資料視覺化、探索式資料分析(EDA)以及統計思維。這些內容看似基礎,卻是所有分析工作的根基。沒有可信的資料,再複雜的模型都沒有價值;沒有正確的分析框架,再漂亮的圖表也只是裝飾。

    第二部分則進一步進入企業實際最常使用的分析方法,包括趨勢分析、交叉分析、根因診斷、客戶分析、分群分析與漏斗分析。我們將學習如何從現象中發現問題,從數據中找出原因,並建立可執行的改善方向。

    第三部分則聚焦於實戰專案。我們將透過完整案例,帶領讀者學習 A/B 測試、流失預測、回歸分析、時間序列預測、促銷效益分析、服務補救分析以及潛客評分系統等主題。這些案例不只是模型練習,更著重於如何將分析結果轉化為企業可以採取的行動。

    你將學會:
    🎯 從商業問題出發,而不是從程式碼出發
      用最容易理解的方式建立數據分析思維,從資料清理、視覺化、EDA 到統計推論,理解每個分析方法背後的商業意義。
    🎯 從描述到診斷:學會企業最常使用的分析框架
       趨勢分析、同比環比、交叉分析、貢獻度分析、根因分析、漏斗分析與客戶分析,建立完整的商業診斷能力。
    🎯 從客戶到營收:掌握企業成長的核心分析工具
       RFM 分析、客戶分群、留存分析、客戶生命週期價值(CLV)、K-Means 分群,深入理解客戶行為與經營策略。
    🎯 從分析到預測:建立數據驅動決策能力
       A/B Testing、流失預測、回歸分析、時序預測、潛客評分系統,學習如何用數據預測未來並降低決策風險。
 
    Part 1——數據分析基礎與商業思維

    第 1 章 數據分析的商業思維
    1-1 數據分析核心導論——從觀念到職涯發展
        1-1-1 數據分析的定義與商業價值
        1-1-2 數據分析的六大黃金流程
        1-1-3 業界四大常用數據分析方法
        1-1-4 實務情境落地——用一間手搖飲店看懂四大分析
        1-1-5 商業核心驅動—如何定義業務的「北極星指標」
        1-1-6 數據分析師的 T 型能力模型
        1-1-7 數據分析師的產業職涯與發展路徑
        1-1-8 數據分析的產業應用場景
    1-2 多維度資料分析架構——OLAP 的核心思考
        1-2-1 線上分析處理與資料方塊概念
        1-2-2 OLAP 的核心操作
        1-2-3 OLAP 在描述性與診斷性分析中的角色
        1-2-4 數據分析師的轉譯思考
    1-3 Pandas 基本操作
        1-3-1 資料讀取與寫入
        1-3-2 描述性統計
        1-3-3 資料選取
        1-3-4 條件式資料過濾
        1-3-5 資料排序
        1-3-6 分組與聚合(Groupby)
        1-3-7 Pandas 樞紐分析表
    1-4 本書的學習地圖——以實務案例貫穿全書

    第 2 章 從原始資料到可信資料
    前言—讓資料從「混亂」變成「可信」
    2-1 資料型別與結構一致性
        2-1-1 初步資料檢查
        2-1-2 資料欄位型別與結構辨識
        2-1-3 型別錯誤與轉換問題
        2-1-4 類別資料清理與轉型
        2-1-5 時間資料與格式問題
    2-2 缺失值處理
        2-2-1 缺失值檢查與分布觀察
        2-2-2 缺失值的本質分類
        2-2-3 缺失值處理策略
    2-3 離群值與資料合理性
        2-3-1 離群值檢測方法
        2-3-2 離群值處理方法
    2-4 資料轉換與基礎特徵工程
        2-4-1 類別資料編碼
        2-4-2 時間欄位拆解
        2-4-3 分箱
        2-4-4 衍生特徵
    2-5 資料品質與合理性檢查
        2-5-1 數值範圍檢查
        2-5-2 業務規則驗證
        2-5-3 重複值檢查
        2-5-4 資料一致性問題
    結語——資料清理的本質,是建立「可信資料」

    第 3 章 資料視覺化——從繪圖到商業溝通
    前言——圖表不是裝飾,而是決策介面
    3-1 視覺化基礎—從資料整理到第一張圖
        3-1-1 為什麼資料視覺化如此重要?
        3-1-2 Pandas、Matplotlib 與 Seaborn
        3-1-3 三大套件繪製直方圖比較
    3-2 視覺感知心理學——大腦如何「看到圖」
        3-2-1 前注意屬性——大腦如何快速注意重點
        3-2-2 格式塔原理——大腦如何自動整理資訊
    3-3 選對圖表——數據關係決定視覺呈現
        3-3-1 比較類——柱狀圖與折線圖
        3-3-2 組成類——堆疊圖、圓餅圖與環形圖
        3-3-3 分佈類——直方圖與箱型圖
        3-4-4 關聯類——散點圖與氣泡圖
        3-3-5 時間序列類—趨勢圖與移動平均
    3-4 商業視覺化與圖表設計原則
        3-4-1 好圖表的核心——資訊優先於裝飾
        3-4-2 如何用圖表說故事
        3-4-3 視覺化中的認知陷阱與誤導
    結語——圖表的終點,是理解與決策

    第 4 章 EDA——從資料中發現規律
    前言——EDA 不是畫圖,而是理解資料的方式
    4-1 單一變數分析——資料本身長什麼樣?
        4-1-1 資料分布的第一印象
        4-1-2 集中趨勢——平均數 vs 中位數
        4-1-3 離散程度——資料穩不穩定?
    4-2 兩變數關係——資料之間有沒有互動?
        4-2-1 相關性初探——有沒有線性關係?
        4-2-2 散點圖中的模式
        4-2-3 類別 vs 數值——群組差異
    4-3 標準化與尺度調整——讓資料可以被公平比較
        4-3-1 Min-Max 正規化
        4-3-2 Z-score 標準化
        4-3-3 正規化與標準化在 EDA 中的角色
    4-4 分群與結構——資料是否有隱藏結構?
        4-4-1 類別分布——誰最多?
        4-4-2 群體差異——不同群行為不同嗎?
        4-4-3 長尾與極端群體
        4-4-4 群體與行為差異
    4-5 從觀察到假設——EDA 的核心輸出
        4-5-1 電商 EDA 案例
    結語——EDA 的價值,是讓資料開始「說話」

    第 5 章 數據分析中的統計思維
    5-1 前言——用統計思維建立可信的數據決策
        5-1-1 隨機性與資料分布
        5-1-2 標準差與業務穩定性
        5-1-3 變異係數與相對風險
        5-1-4 大數法則與肥尾效應
    5-2 抽樣與信賴推論
        5-2-1 常見抽樣方法
        5-2-2 樣本量與估計精度
        5-2-3 信心區間與不確定性
    5-3 假設檢定與 A/B 測試
        5-3-1 虛無假設與 p 值
        5-3-2 t 檢定與雙組比較
    5-4 變異數分析(ANOVA)
        5-4-1 組間差異與組內波動
        5-4-2 事後檢定—─找出真正的優勝方案
        5-4-3 效果量——顯著不等於重要
    結語—─統計學在數據分析中的價值

    Part 2——商業分析方法與決策診斷

    第 6 章 趨勢與對比分析
    前言——數據真正的價值,不在數字本身
    6-1 對比的力量
        6-1-1 數據孤島的悲劇
        6-1-2 對比的五個核心維度
    6-2 同比與環比——如何辨識真正的成長
        6-2-1 環比——短期策略的溫度計
        6-2-2 同比——排除季節性的長期座標
        6-2-3 增長的陷阱——當環比與同比發生衝突
        6-2-4 複合增長率——數據的長線定海神針
        6-2-5 偽成長與假衰退——數據誤判的常見陷阱
        6-2-6 滾動同比——避免季節錯覺的進階同比分析
    6-3 移動平均——從噪音中看見趨勢
        6-3-1 核心概念——用「平均」對抗「噪音」
        6-3-2 黃金交叉與趨勢轉折
    6-4 指數化分析
        6-4-1 指數化——看見真正的成長軌跡
    結語——分析趨勢,不只是觀察數字

    第 7 章 交叉分析與根因診斷
    前言——從異常現象到問題定位
    7-1 交叉分析
        7-1-1 維度與指標
        7-1-2 分層分析的重要性
        7-1-3 商務強度矩陣
        7-1-4 從交叉表發現機會與風險
    7-2 貢獻度分析
        7-2-1 貢獻度分析的核心概念
        7-2-2 實作範例——商品貢獻度分析
        7-2-3 Pareto 分析——找出最值得優先處理的商品
    7-3 異常分析
        7-3-1 異常值與商業訊號
        7-3-2 實戰演練——門市營收異常診斷
    7-4 根因分析
        7-4-1 RCA 與描述性分析的差異
        7-4-2 假說驅動分析
        7-4-3 四層下鑽法
        7-4-4 從現象到決策——資料到行動的閉環
    7-5 根因分析實戰案例報告
    結語——從數據觀察者到問題診斷者

    第 8 章 客戶分析與分群策略
    前言——從異常現象到問題定位
    8-1 客戶價值分析
        8-1-1 客戶分析的核心思維
    8-2 RFM 模型
        8-2-1 RFM 的商業邏輯
        8-2-2 建立客戶分群矩陣——將行為數據轉譯為營運戰略
        8-2-3 基於 RFM 的多維交叉排查
    8-3 客戶留存分析
        8-3-1 留存率與生命週期防線
        8-3-2 流失率與流失弱訊號偵測
        8-3-3 回購率的商務盲點
        8-3-4 世代分析與時序矩陣
        8-3-5 客戶生命週期價值的動態估算
    8-4 客戶分群實戰
        8-4-1 K-Means 分群
        8-4-2 高價值客群辨識
        8-4-3 機器學習分群實作
        8-4-4 在 OLAP 中利用 K-Means 標籤進行多維下鑽
    結語——從數據矩陣回歸「人本決策」的分析思維

    第 9 章 漏斗分析與根因診斷
    前言—從轉換率到根因診斷
    9-1 漏斗模型與轉換路徑分析
        9-1-1 漏斗分析的本質——結構化拆解
        9-1-2 Funnel 分析前的資料可信度檢查
        9-1-3 從事件流建立漏斗
        9-1-4 漏斗轉換率與流失率之雙軌計算
        9-1-5 視覺化漏斗與雙軌指標診斷
    9-2 多維漏斗分析
        9-2-1 多維漏斗的建構心法與維度選擇
        9-2-2 實作多維漏斗矩陣
        9-2-3 視覺化多維漏斗——群組對比圖實作
    9-3 時間維度下的漏斗動態觀測
        9-3-1 漏斗轉換的時間窗效應
        9-3-2 佇列分析與漏斗指標的時序漂移
    9-4 漏斗瓶頸的質化根因深度下鑽
        9-4-1 行為流向還原——從漏斗事件到流失原因建模
    9-5 從診斷到落地——漏斗優化策略與 A/B 測試驅動
        9-5-1 減少漏斗摩擦力的營運與產品藥方
        9-5-2 利用 A/B 測試科學驗證漏斗優化成效
    結語——數據分析的終點不是報表,而是改變結果

    Part 3——預測分析與商業決策實戰

    第 10 章 A/B 測試與數據決策實務
    10-1 前言——從實驗數據到產品決策
        10-1-1 實戰沙盒——資料集介紹與分析架構
        10-1-2 數據初步檢查
    10-2 實驗設計的核心
        10-2-1 為什麼需要北極星指標
        10-2-2 玩家路徑與 Gate 設計
        10-2-3 核心指標定義——D1、D7 與 LTV
    10-3 實戰 A/B 測試——從隨機分派到因果推論
        10-3-1 建立實驗假設——延後門檻是否真的更好?
        10-3-2 分組均衡性檢查——樣本與 SRM 風險防線
        10-3-3 偏差程度的量化——SRM 是大問題還是可接受雜訊?
        10-3-4 A/A 測試概念引入——驗證實驗系統的零偏誤
    10-4 頻率派檢定 vs 貝氏推論——加速產品決策的兩種思維
        10-4-1 傳統 p-value 的限制
        10-4-2 貝氏 A/B Testing 原理——Beta-Binomial 後驗分佈
        10-4-3 機率模擬實作——使用蒙地卡羅方法進行貝氏 A/B 比較
    10-5 分群分析——挖掘隱藏在平均數下的真相
        10-5-1 辛普森悖論的商務風險
        10-5-2 依玩家涉入程度分群分析
    10-6 預期損失與商務落地決策
        10-6-1 風險量化
        10-6-2 決策門檻設定——從統計顯著到商業可行性
        10-6-3 結合統計結果與開發成本的最終博弈
        10-6-4 實驗不是終點,而是下一輪優化的起點
    結語——數據不是答案,而是降低決策風險的方法

    第 11 章 用戶流失預測與機器學習防禦系統
    11-1 前言——從「靜態留存」到「動態預測」的流失分析框架
        11-1-1 實戰沙盒——資料集介紹與分析架構
        11-1-2 數據初步檢查
    11-2 特徵工程與特徵篩選
        11-2-1 數值型特徵的陷阱
        11-2-2 類別變數的商務轉譯
        11-2-3 衍生特徵——商業訊號的重建
        11-2-4 基準線設定——模型價值的起點,而非比較結果
    11-3 模型構建與效能評估
        11-3-1 特徵選擇與基準模型建立
        11-3-2 確立評價體系
        11-3-3 精準度與召回率的取捨
        11-3-4 F1-Score 與 ROC-AUC
    11-4 商務決策落地——從流失預測到獲利最佳化
        11-4-1 建立流失挽回的 ROI 模型
        11-4-2 挽回機率的變動敏感度分析
        11-4-3 流失挽回的決策分層——避免資源錯配與利潤稀釋
    11-5 模型優化與模型解釋性分析
        11-5-1 交叉驗證
        11-5-2 超參數調優
        11-5-3 模型解釋性分析
        11-5-4 SHAP 相依圖分析——尋找風險臨界點
    結語——從預測模型走向可執行的決策系統

    第 12 章 回歸分析——鑽石定價與價值挖掘
    12-1 前言——從價格表象到價值建模
        12-1-1 實戰沙盒——資料集介紹與分析架構
        12-1-2 數據初步檢查
    12-2 數據預處理——從原石到精琢特徵
        12-2-1 數據清洗——排除異常與不合理紀錄
        12-2-2 類別編碼——等級排序與市場語言轉譯
        12-2-3 相關性掃描——價格驅動因子與結構辨識
    12-3 線性回歸實作——建立商業定價基準
        12-3-1 線性回歸的商業意義——從預測工具到定價語言
        12-3-2 係數的商業意義——從參數到決策規則
        12-3-3 截距的意義——定價邏輯中的「地板價」是否存在?
        12-3-4 模型評估——R2 衡量了多少價格波動?
        12-3-5 模型評估——使用 MAE 與 RMSE 評估定價誤差
    12-4 殘差分析——診斷模型的偏見與盲點
        12-4-1 殘差分布圖——檢查誤差是否符合常態分佈
        12-4-2 模型優化方向——使用多項式迴歸
        12-4-3 模型優化方向——使用 log 對數轉換
        12-4-4 模型優化方向——同時使用多項式與對數轉換
        12-4-5 穩健性檢驗——K-Fold 交叉驗證
    12-5 商業決策應用——溢價預警與自動採購決策
        12-5-1 溢價分析——從殘差中尋找市場錯價機會
        12-5-2 區間估計——從單點預測到風險定價
        12-5-3 模擬情境——市場結構變動下的庫存價值重估
    結語——從價格預測到價值洞察

    第 13 章 時序分析與商業預警實戰
    前言——從解釋過去到預測未來
        13-1 時間序列的本質——從靜態數據到動態系統
        13-1-1 時間不只是維度,而且是生成機制
        13-1-2 趨勢、季節性與隨機性的三分結構
        13-1-3 商業數據中的慣性與延遲效應
    13-2 預測的前提——資料是否「可預測」
        13-2-1 平穩性的商業意義
        13-2-2 觀察平穩性
        13-2-3 差分技術——把斜率拍扁
    13-3 經典模型實戰——ARIMA 與自動化預測系統
        13-3-1 ARIMA 的結構拆解——AR/I/MA 的意義
        13-3-2 建立 ARIMA 模型
        13-3-3 建立 SARIMA 模型
        13-3-4 建立 SARIMAX 模型
    13-4 Auto-ARIMA——從手動調參到自動搜尋
        13-4-1 統計學的裁判——AIC 與 BIC 的商業直覺
        13-4-2 Auto-ARIMA 實戰——自動搜尋不等於自動理解
        13-4-3 Auto-ARIMA 實戰——季節性的影響
        13-4-4 Auto-ARIMA 實戰——讓模型理解商業事件
    13-5 預測區間——從單點預測到風險決策
        13-5-1 信心區間與預測區間的本質差異
        13-5-2 從歷史資料走向未來決策——SARIMAX 實戰預測
        13-5-3 數據工程的核心難題——未來外生變數從何而來
    結語——讓數據成為企業的前瞻雷達

    第 14 章 折扣與促銷策略分析——從業績表象到價值拆解
    14-1 前言——從銷量表象到商業因果理解
        14-1-1 實戰沙盒——資料集介紹與分析架構
        14-1-2 數據初步檢查
    14-2 促銷增量分析
        14-2-1 基準線——建立「如果沒有促銷」的參考座標
        14-2-2 增量業績計算——量化促銷活動的真實效果
        14-2-3 損益平衡點——這場仗打得值得嗎?
    14-3 收益鏈分析——從引流商品到整體獲利
        14-3-1 關聯性檢驗——主機真的帶動配件嗎?
        14-3-2 促銷投資效益分析——從引流成本到整體損益評估
    14-4 替代效應與業績侵蝕——成長背後的內部消耗
        14-4-1 市場結構拆解——主機與競品的位移真相
        14-4-2 品類淨利潤評估——警惕利潤空洞化
    14-5 跨期需求移轉分析——促銷是否只是「向未來借業績」
        14-5-1 囤貨效應辨識——消失的訂單只是被提前了
        14-5-2 需求透支評估與活動排程——找回獲利的節奏
    結語——從數字變動到商業邏輯的還原

    第 15 章 服務補救效應與忠誠度歸因
    15-1 前言——當危機成為忠誠度的起點
        15-1-1 實戰沙盒——服務與交易的數據縫合
        15-1-2 數據初步檢查——確保補救資料的行為真實性
    15-2 服務失敗與心理帳戶——服務補救如何轉化為增量利潤
        15-2-1 服務補救悖論的定義——危機中的忠誠度飛躍
        15-2-2 期待落差與情緒槓桿——心理學視角的價值轉化
        15-2-3 沉默的代價——當離開沒有被說出口
    15-3 數據實驗設計——如何界定「補救成功」的樣本?
        15-3-1 回顧性隊列的建構——從歷史資料中重建實驗
        15-3-2 排除異常值與偏誤
    15-4 忠誠度升幅量化——計算「補救後」的行為變異
        15-4-1 再購頻次與存活分析——預測未來的購買節奏
        15-4-2 信任的變現能力——從客單價提升到生態系消費
    15-5 客服中心的損益表——從成本中心到價值引擎
        15-5-1 補救成本 vs 利潤增量——建立財務歸因公式
        15-5-2 補救甜蜜點探尋——速度與金額的邊際效應
    結語——服務補救的本質,是重新定價關係

    第 16 章 基於「行為軌跡」的潛客評分系統
    16-1 前言——從「盲目追蹤」到「精準捕獲」的意圖識別
        16-1-1 實戰沙盒——資料集介紹與分析架構
        16-1-2 數據初步檢查
    16-2 商務邏輯與評分機制——資源配置的核心框架
        16-2-1 資源配置失衡與潛客優先級問題
        16-2-2 屬性維度評分實作——潛客資格的門檻建構
    16-3 行為特徵工程——從數位軌跡到意圖熱力建模
        16-3-1 數位足跡權重化——行為價值的分層建模
        16-3-2 線上與線下的縫合——建立完整意圖軌跡
        16-3-3 行為評分實作與特徵持久化
    16-4 建立動態評分模型
        16-4-1 時間衰減機制——建立具時效性的潛客評分
        16-4-2 建立潛客評分模型——用機率量化成交可能性
        16-4-3 商務落地應用——從潛客評分到資源配置決策
        16-4-4 模型監控與持續優化——建立可進化的潛客評分系統
    結語——讓數據告訴你,下一位成交客戶是誰
 
    鄭博元

    畢業於澳洲臥龍崗大學(University of Wollongong)商學碩士。
    曾任職於退輔會訓練中心擔任訓練師,並歷任成佳資訊公司系統工程師、台灣 NEC系統工程師、大亞電腦資訊講師,以及輔仁大學城區部推廣教育中心資訊講師。

    早年專注於系統開發相關工作,累積豐富的實務經驗。近年結合商業背景與系統開發專長,投入數據分析領域,專注於數據分析在商業決策與實務應用上的發展,並將相關經驗系統化整理,應用於教學與培訓,深獲學員肯定。

    主要專長:數據分析於商業領域之應用。


博碩文化客服信箱
 

[email protected]

 
文教業務團隊
台北、新北、桃園、基隆、宜蘭、花蓮、金門
汪 玉 鳳
LINE ID:0925177716
0925-177716
[email protected]
助理分機 519
新竹、苗栗、台中、彰化、南投、雲林
嘉義、台南、高雄、屏東、台東、澎湖
林 月 玲
LINE ID:0926858627
0926-858627
[email protected]
助理分機 238


博碩文化股份有限公司 DrMaster Press Co., Ltd.
台灣新北市汐止區新台五路一段112號10樓A棟
Building A, 10F, No.112, Xintai 5th Rd., Sec.1,Xizhi Dist., New Taipei City 221, Taiwan
Tel:02-2696-2869 Fax:02-2696-2867 劃撥帳號:17484299

Copyright© DrMaster Press Co., Ltd. All Rights Reserved.